从资源服务到数据智服 光络云重构AI大模型全球化数据基建
在生成式AI与大模型技术席卷全球的今天,算力、算法与数据被誉为驱动智能革命的“三驾马车”。当业界将目光聚焦于GPU集群规模与模型参数量的指数级增长时,一个更为根本的瓶颈正日益凸显——如何为AI大模型构建一套高效、合规、智能的全球化数据基础设施。光络云,作为互联网数据服务领域的深耕者,正以“从资源服务到数据智服”的跃迁,重新定义AI时代的全球化数据基建。
资源服务的天花板:传统数据服务的局限性
长期以来,互联网数据服务主要扮演“资源管道”的角色——提供IDC机房、带宽、CDN加速以及爬虫采集等基础资源。对于早期的AI模型训练而言,这种模式尚能满足“数据喂饱”的基本需求。但随着大模型参数规模迈入万亿级、多模态数据成为常态,传统资源服务模式暴露出三大痛点:
- 孤岛化:数据分散在不同云、不同区域、不同格式中,跨境传输与调度成本高昂,难以形成全局数据视图。
- 粗放化:单纯堆砌存储与带宽,缺乏对数据质量、时效性、血缘关系的治理,导致“垃圾进、垃圾出”。
- 合规风险:全球各地数据主权法规各异,传统资源服务难以在满足GDPR、CCPA等合规要求的同时实现高效流动。
显然,大模型的全球化训练与推理,需要的不是简单的“数据搬运工”,而是能理解数据、调度数据、治理数据的“智能服务中枢”。
何为“数据智服”?光络云的三重跃迁
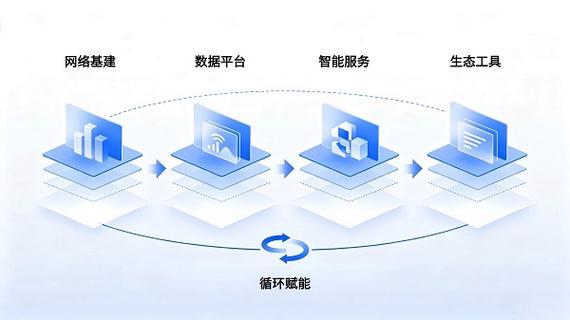
光络云提出的“数据智服”(Data Intelligent Service),并非文字游戏,而是对数据服务价值的重构。其核心是以AI驱动数据全生命周期管理,将数据从静态资源转变为可智能调度、主动优化、合规可信的生产要素。具体而言,光络云通过三重跃迁实现这一目标:
第一重:从“带宽带宽”到“感知网络”。 光络云构建了覆盖全球的智能数据感知网络,通过部署在边缘节点的轻量级探针,实时感知各区域数据源的质量、格式与可用性。当大模型训练需求发生变化时,网络可自动推荐并预热最优数据路径,将跨域数据传输时延降低40%以上。
第二重:从“存储仓库”到“治理引擎”。 光络云自研的DataOps平台集成了自动化标注、去重、脱敏与向量化能力。针对大模型预训练,平台可动态筛选高信息密度样本,去除冗余与噪声,在不损失性能的前提下将训练数据集压缩30%-50%,显著降低算力消耗。
第三重:从“统一标准”到“主权计算”。 面对全球数据合规挑战,光络云率先引入“数据主权容器”技术。数据在离开原属区域前即完成脱敏与加密,携带细粒度访问策略。即便数据汇聚到海外训练集群,原始主权的策略引擎仍可在线监管,实现“数据可用不可见、流動可审计”。
原子化能力支撑全球化基建
光络云的“数据智服”体系之所以能重构AI全球化数据基建,依托于一组可在线编排的原子化能力:
- 全球边缘数据缓存:在20+国家部署轻量级缓存节点,支持PB级热数据本地毫秒级命中。
- 自适应数据压缩与传输协议:自研WireReduce算法,在HTTP/3基础上实现训练样本的动态分片与有损/无损自协商压缩。
- 大模型专属数据通道:为Llama、GPT、文心等主流框架提供即插即用的加速网关,将数据加载耗时从分钟级降至秒级。
- 合规智能路由:实时解析每批数据的标签与目的地法规,自动选择最安全的物理路径与加密等级。
实践案例:助力国产大模型出海
某头部AI企业计划在东南亚与中东训练多语言大模型,需整合社交、电商、新闻等十亿级多模态数据。利用光络云的数据智服体系,该企业仅用两周便完成了数据发现、合规清洗与跨国同步。训练在线发现,数据实际有效吞吐提升3倍,因格式错误和主题偏移导致的epoch浪费下降超60%。模型最终在中东语NLU任务上相比基座提升了11.7%。
展望:数据智能时代的基础设施范式
光络云的探索揭示了一个趋势:AI大模型的全球化竞争,本质上是数据基础设施智能化水平的竞争。从“资源服务”到“数据智服”,不只是能力的叠加,更是价值逻辑的升维——让数据主动适配模型、让合规成为能力而非阻碍、让全球流动像本地读取一样平顺。
光络云相信,当数据基础设施本身具备AI智慧,大模型才能真正洞察人类文明的多样编码,走向更大的全球化普惠智能。这条征途刚落笔,但路标已经清晰:重塑数据基建,即重塑AI的未来。
如若转载,请注明出处:http://www.gtkyx.com/product/39.html
更新时间:2026-10-05 15:52:07